最近、ChatGPTの画像生成機能で自分の描いたキャラクターをもとにイラストを作って遊んでいる。

自分の絵から綺麗なイラストや設定資料ができるのは普通に楽しいんだけど、何枚も作っているとだんだん欲が出てくる。同じキャラクターのまま、好きな衣装で、好きなポーズを取らせたい。できれば怪人と戦っているところも見たい。何よりGPT ImageやNanobananaのようなクラウドの画像生成AIはコンテンツポリシーというハードルがあるので、エロは無理だし暴力表現も無理。R-18どころかR-15ぐらいの内容でも普通に無理。AIによって創作が民主化されたとはいうけれど、クラウド上のAIではコンテンツポリシーがあるかぎり本当の民主化には程遠い。
というわけで今回は、自作の女性ヒーロー「あかり」のLoRAを作り、ComfyUIで使えるようにするところから、Google Colabでオンライン学習するところまで試してみた。作業にはCodexも使っている。コードや学習環境の準備を手伝ってもらいつつ、自分は生成された画像を見て、ここが違う、そこは直してほしい、と注文をつける感じ。
今の時点で学習環境はかなり整った。ただ、元の画像と同じキャラを同じ衣装で安定して出すというのは、思っていた以上に難しい。


そもそもLoRAとは
画像生成AIを使っているとよく出てくるLoRA。ざっくり言えば、元になるモデルにキャラクターや絵柄などの特徴を追加で覚えさせるための仕組み。モデル全体を一から作り直すのではなく、追加学習した比較的小さなデータを組み合わせて使う。今回なら、イラストを描く能力を持ったモデルに「〇〇はこういうキャラです」と覚えてもらうことになる。
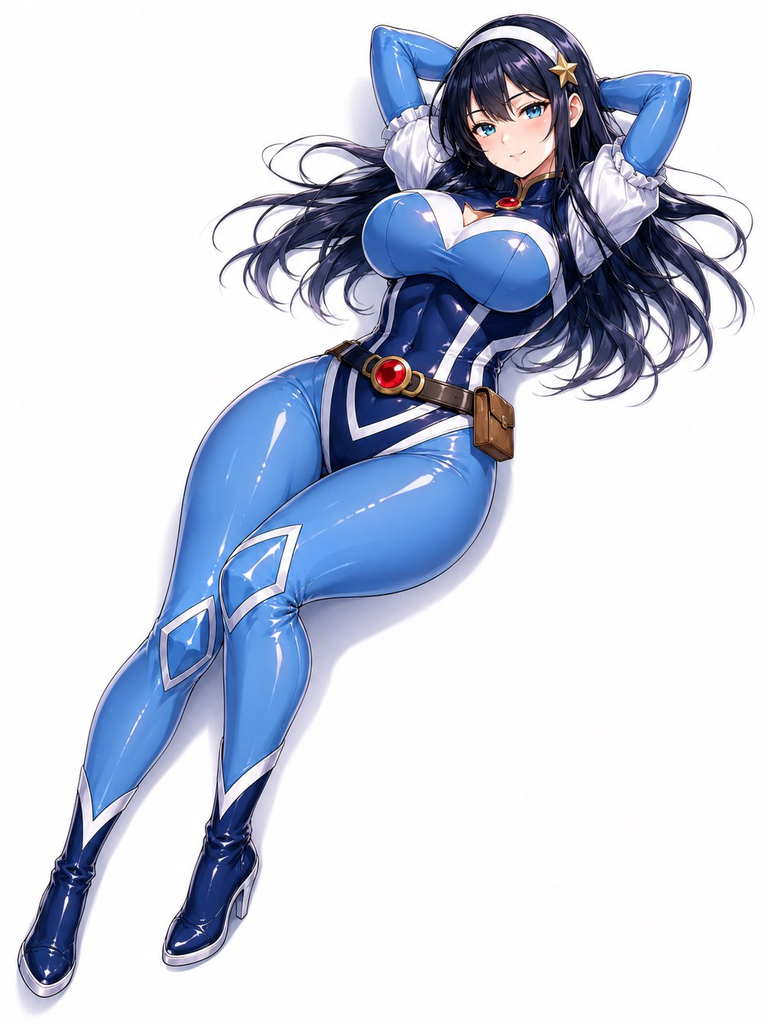
文章だけでも「青いスーツを着た黒髪の女性ヒーロー」は出せる。でも、それだけだと毎回微妙に違う人が出てくる。髪型も違えば服も違うし、装飾品も勝手に増えたり減ったりする。そこで顔や髪型、衣装の特徴をLoRAとして学習させて、同じキャラを呼び出しやすくしたいというわけ。
ちなみにLoRAは何にでも使える万能な追加データというわけではなく、元のモデルの系統との対応が必要。今回も途中でモデルを変更したので、そのまま使い回すことはできず、新しく学習し直すことになった。
今回覚えてもらうキャラ
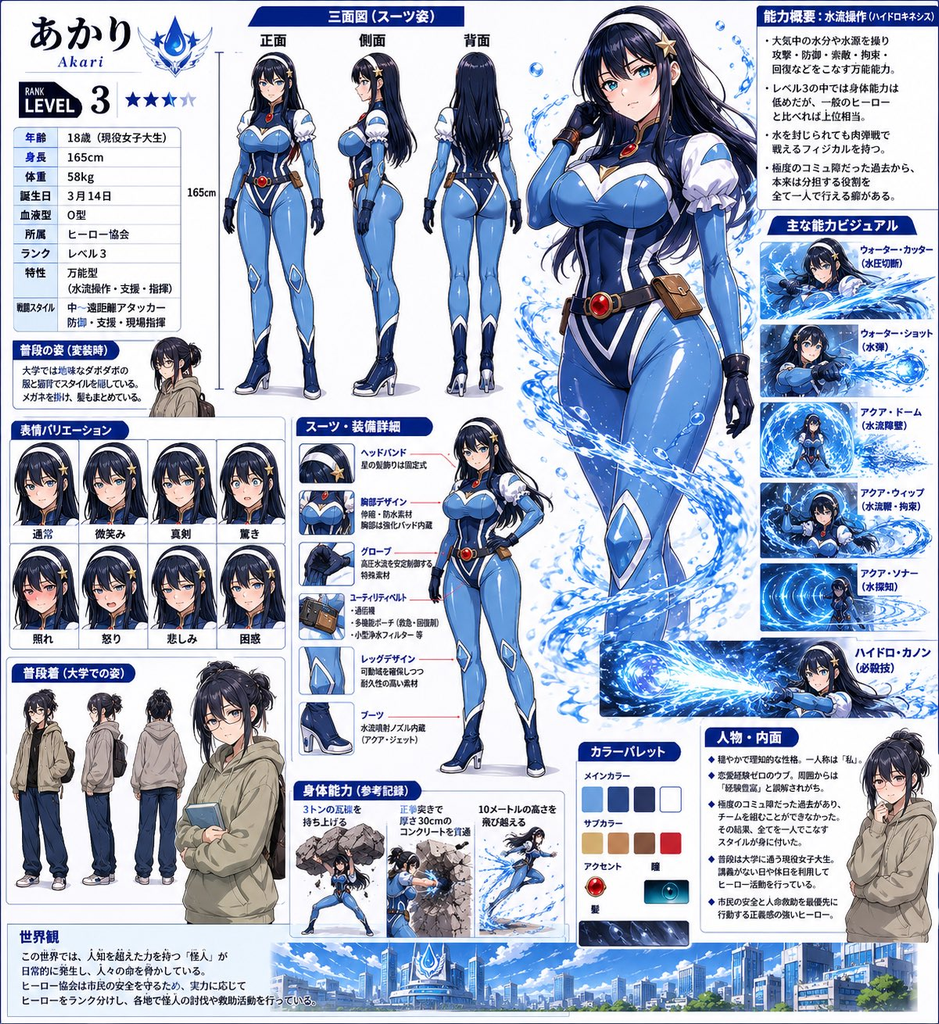
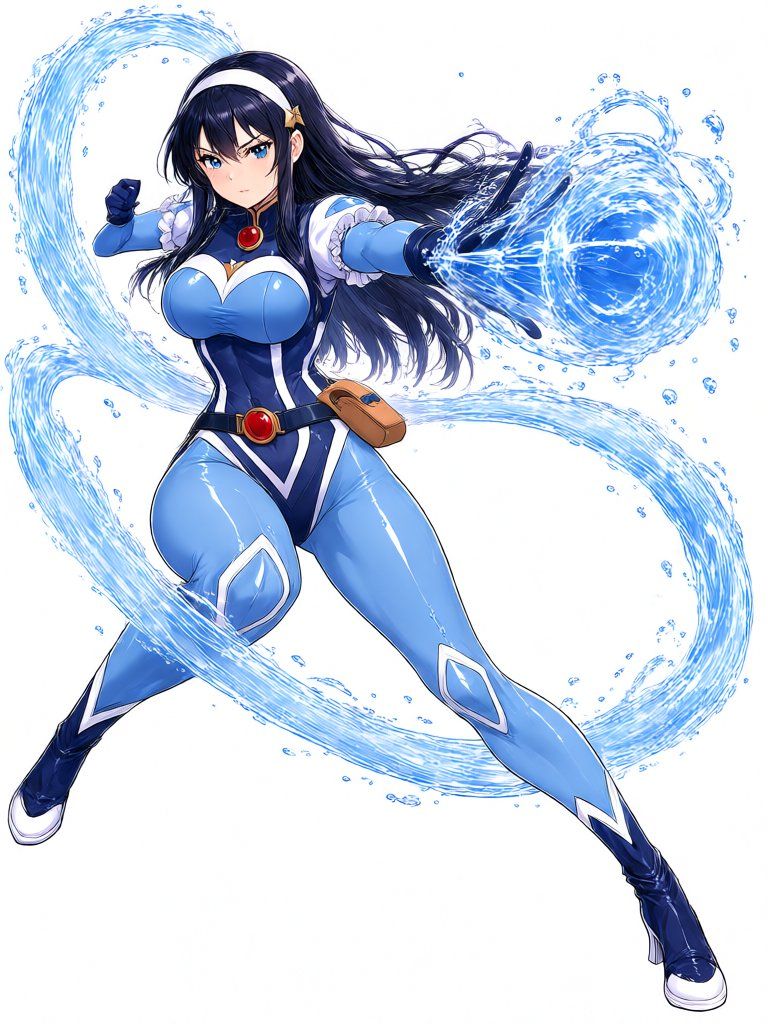
今回のキャラクターは、水を操って戦う女性ヒーローの「あかり」
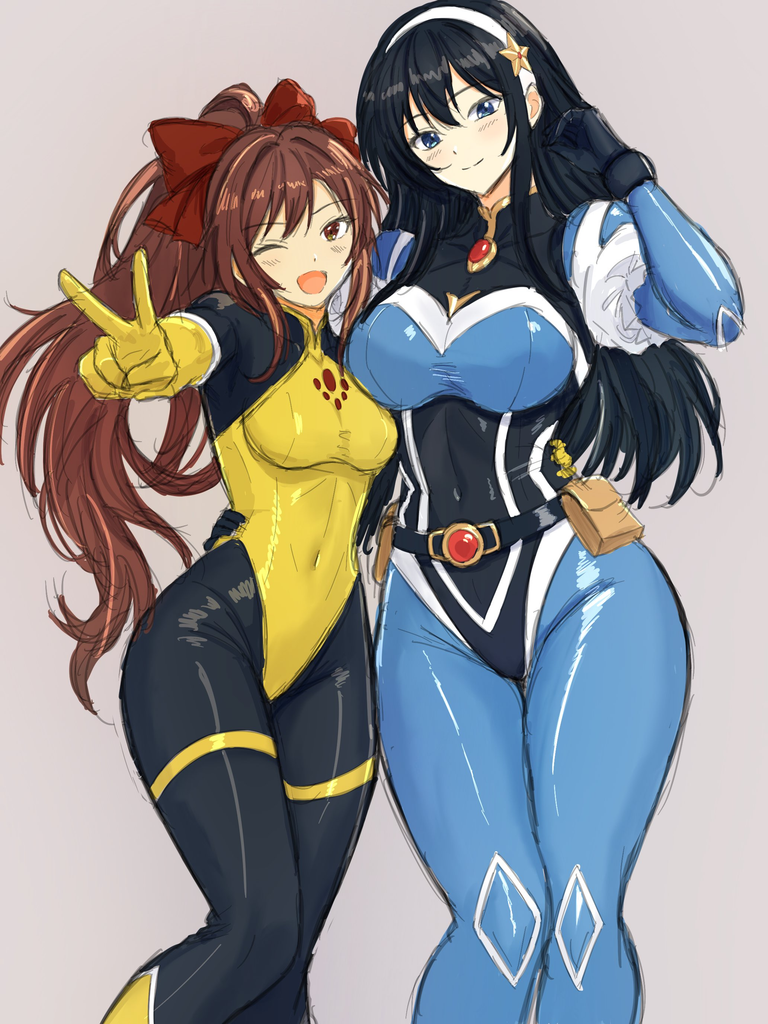
自分で描いたイラストをもとに、ChatGPTの画像生成機能で設定資料やイラストを作成し、それを参考画像として使っている。
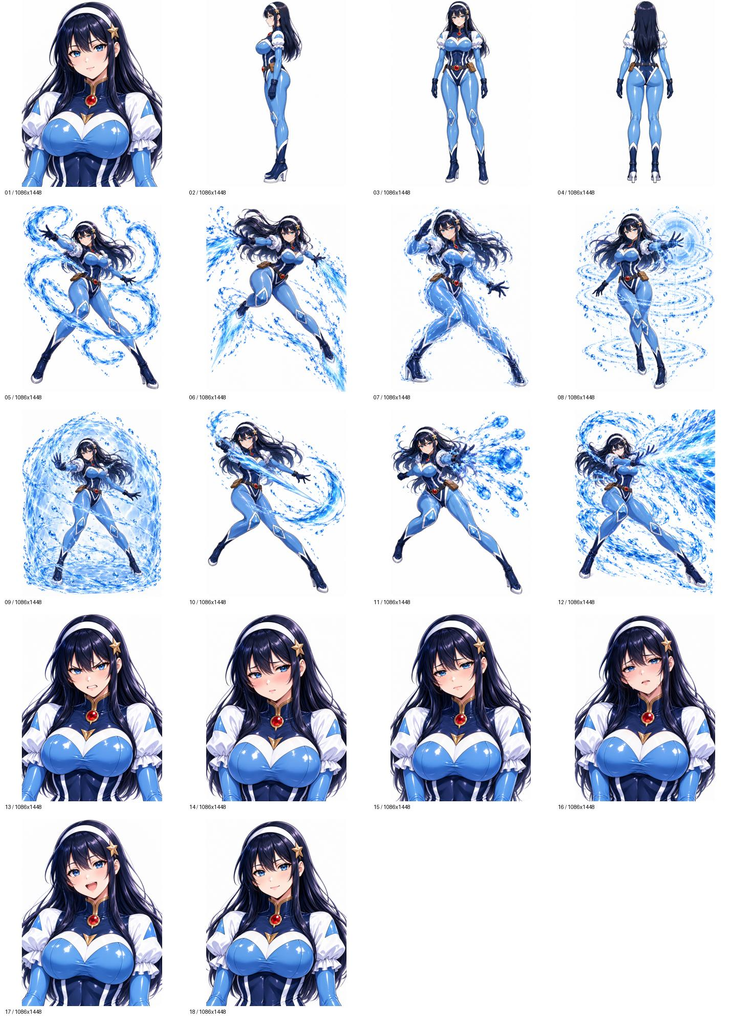
長い紺色の髪に白いヘッドバンド、金色の星飾り。青と紺のスーツに白い袖、赤い宝石のついたベルトというデザインなんだけど、こうして文章にするとそこまで複雑には見えない。
問題は細部。
星飾りは本人から見て左側。胸元には白いラインがあって、腰にも決まった形の白いラインがある。ポーチの位置や数も決まっているし、襟元やブーツにも特徴がある。
人間なら設定画を見ながら確認できるところでも、画像生成ではその辺が結構自由。大まかな色とシルエットは合っているのに、よく見ると別の衣装になっていたりする。
可愛いイラストが出ることと、自分のキャラが正しく出ることは、意外と別の問題だった。
最初はPC本体で学習していた
最初は手元のPCでLoRAの追加学習を進めていた。
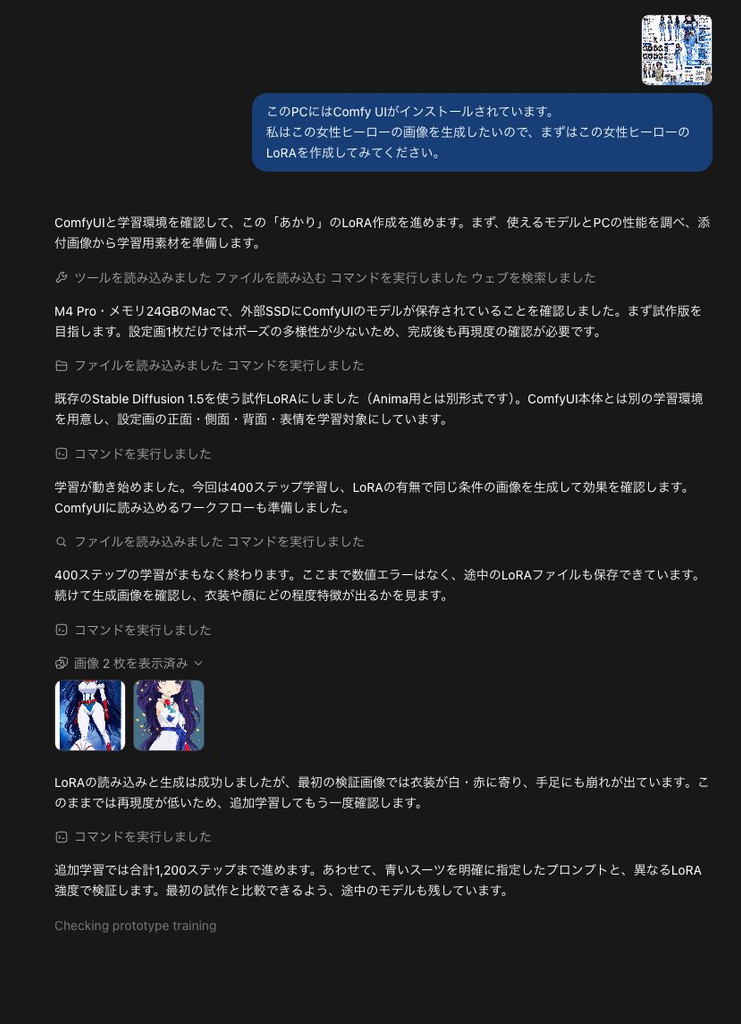
画像を用意して、画像の内容を説明するキャプションを付けて、学習させる。できたLoRAを使って生成し、参照画像と見比べてまた調整する。やっていること自体はこの繰り返し。
生成側にはComfyUIを使う。モデルを読み込む、LoRAを適用する、文章を入力する、画像を出す、といった処理をノードでつなげていくソフト。
最初は配線図みたいでちょっと身構えるけど、設定をワークフローとして保存できるのは便利。同じ条件でLoRAだけ変えて比較するような作業とも相性が良い。
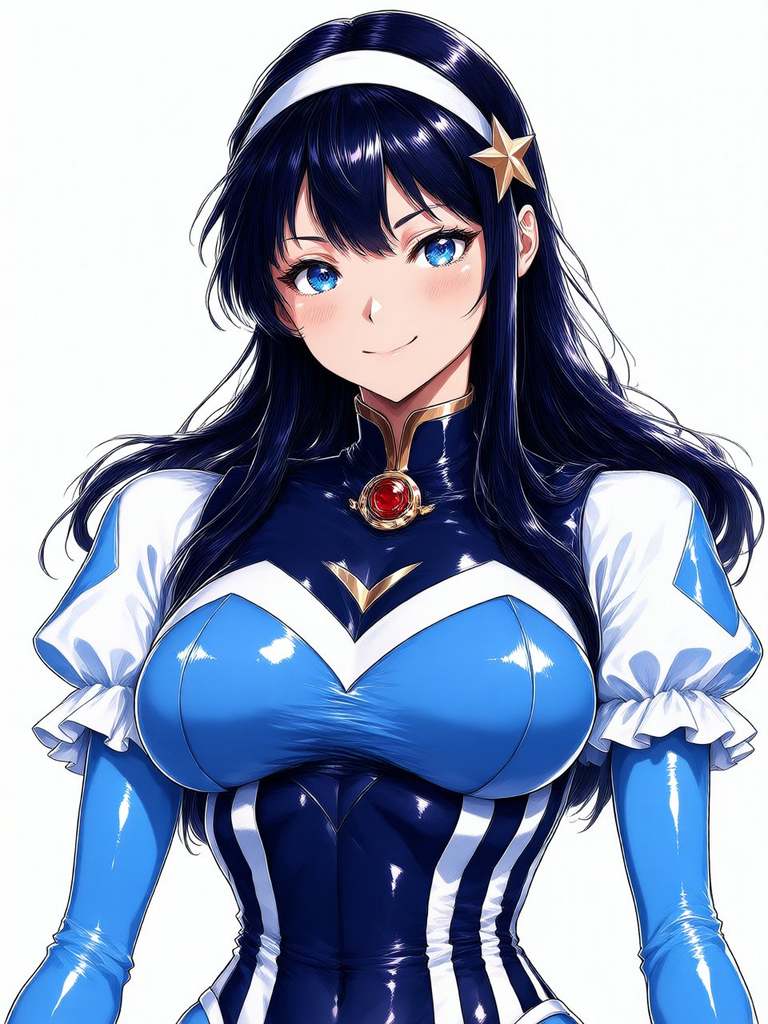
今回はAnima向けのLoRAを作り、追加画像を用意しながら学習を進めていった。
ただ、ここで分かってきたのが、学習を増やせば増やすほど素直に良くなるわけではないということ。
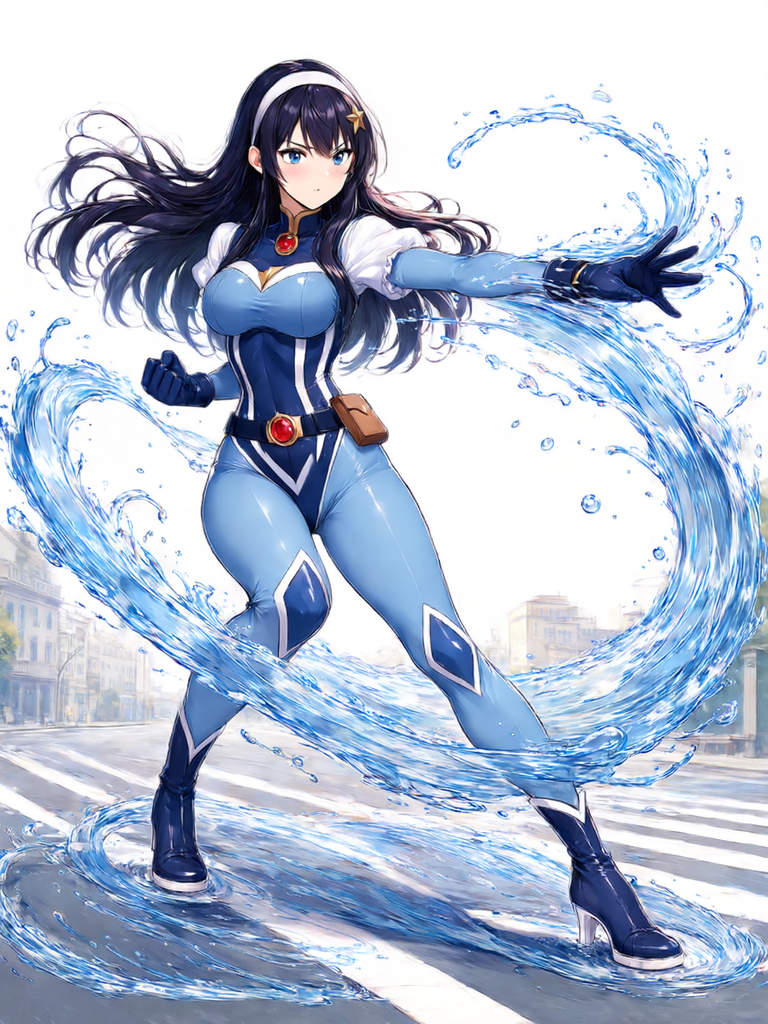
実際に960ステップと1080ステップまで進めたものを比較しても、後者が全面的に良いとは言えなかった。星飾りが出るようになっても、衣装の別の部分が安定しない。顔の雰囲気は良いのに、ポーチや襟元が違う。
数字が増えたから上位互換、とはいかない。これはちょっと面倒だけど、ちゃんと画像を見比べる意味があるところでもある。
枚数を増やす前に、画像を整理する
追加学習というと、とにかく画像を大量に入れれば良さそうに思える。
自分も追加の参考画像をフォルダに保存して、そこからさらに学習を進めてもらった。ただ、枚数だけ増えても、同じような画像ばかりだったり、画像ごとに衣装が微妙に違っていたりすると、何を正解として覚えてほしいのかが曖昧になる。
今回のSDXL向けの準備では、それまでの素材から重複を除き、元画像18枚と細部の切り抜き6枚、合計24枚に整理した。
全身画像は頭や足が切れないよう、白い余白を付けて1024×1024に統一。星飾りの左右が大事なので、左右反転も使わない構成にした。
さらに画像の説明文も見直した。前の環境で使っていた長い説明をそのまま持ってくるのではなく、今回使うモデルの入力に合わせて短く整理している。
この辺は地味。生成された綺麗な画像と違って、見ていて楽しい部分ではない。
でも、間違った資料を大量に渡してから「正確に覚えて」と言っても無理がある。学習回数を増やす前に、まず資料の方を整える必要があった。
戦闘シーンにするとさらに難しくなる
自分が作りたいのは、ただ立っている設定画だけではない。
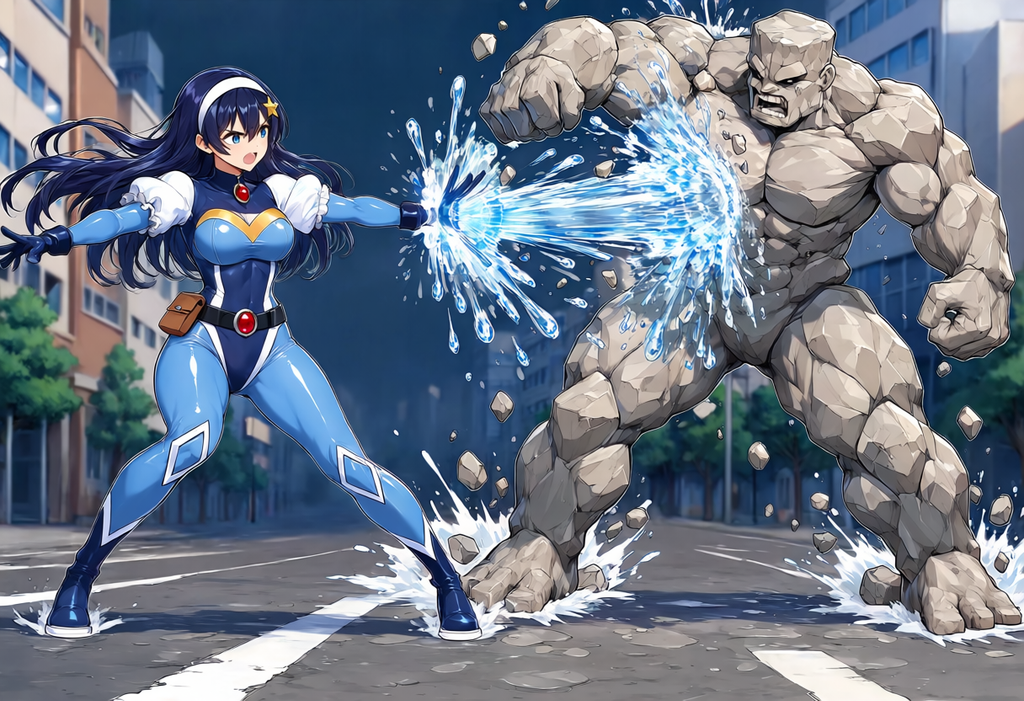
怪人と向き合って水撃を放ったり、攻撃を防いだりする、ヒーローとして実際に戦っているところ、そしてゆくゆくはクラウドの生成AIではコンテンツポリシーに引っかかるようなエロシーンも作りたい。むしろエロがやりたくてローカル生成AIに手を出した面もあるんだから。
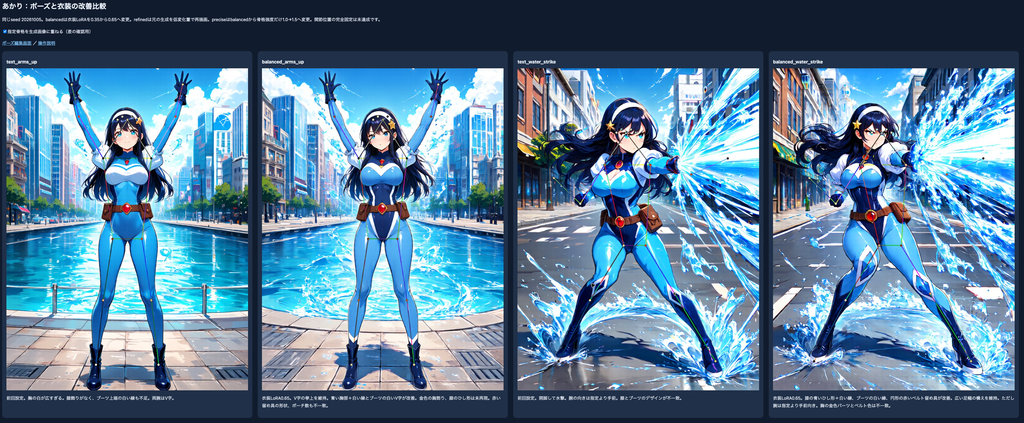
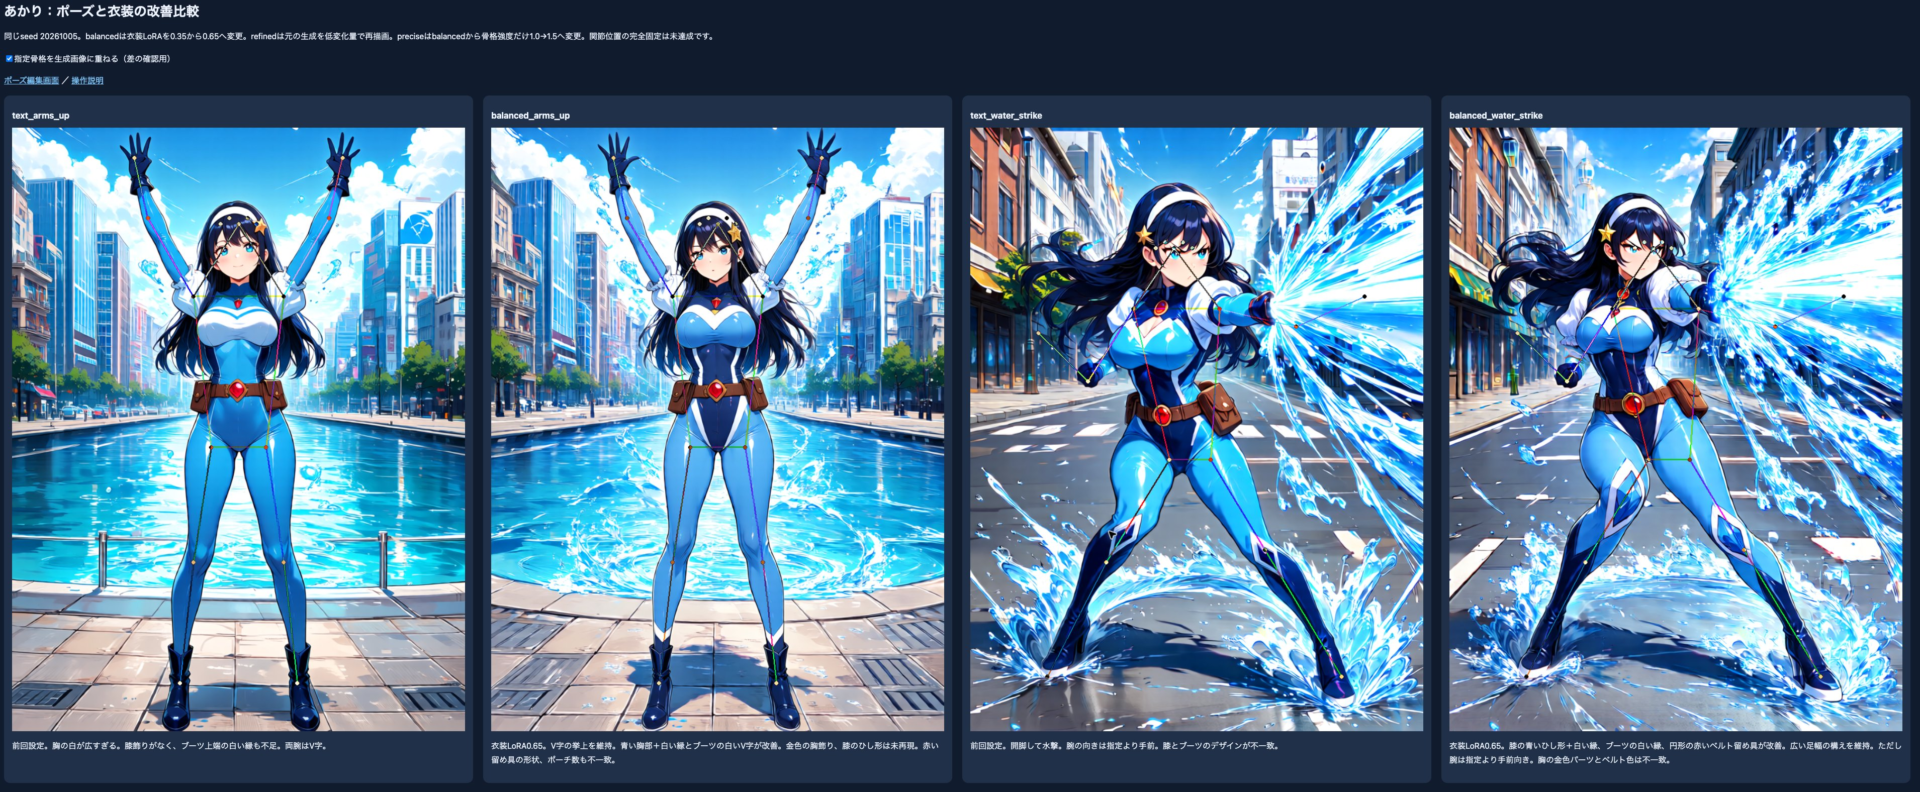
ただ、ここまで来るとキャラの再現に加えて、ポーズ、敵との位置関係、水のエフェクトまで考える必要がある。派手な水を出したら腕が隠れるし、動きを付けたら衣装の形が変わるし、敵を入れると構図自体が難しくなる。
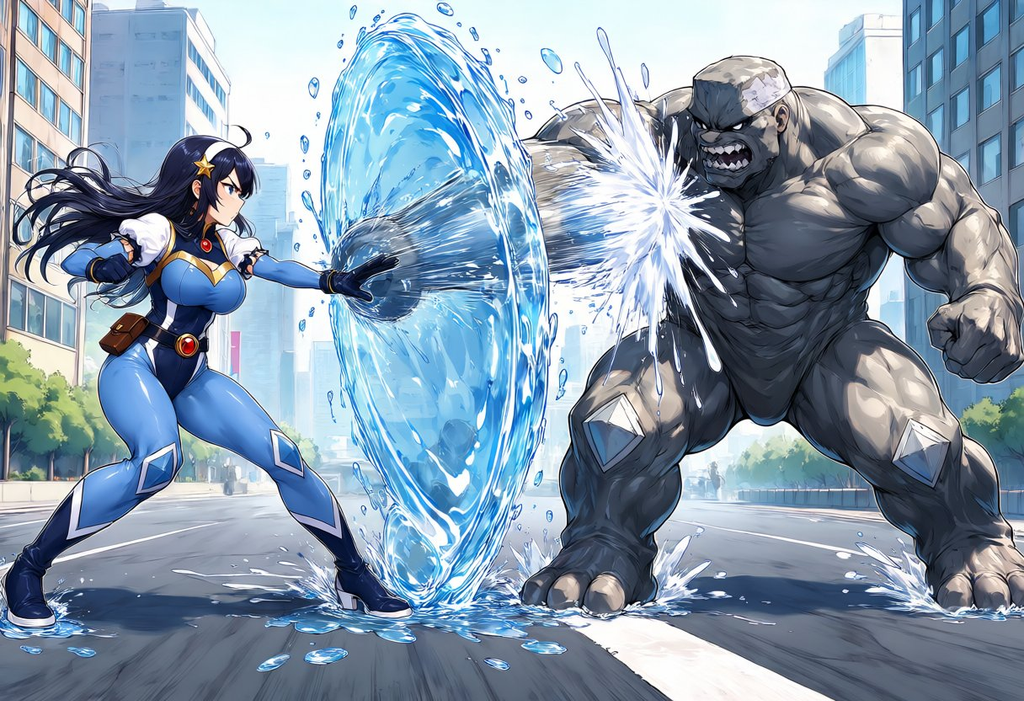
そこでポーズを指定するためにControlNetを使う方向でも改善を進めた。
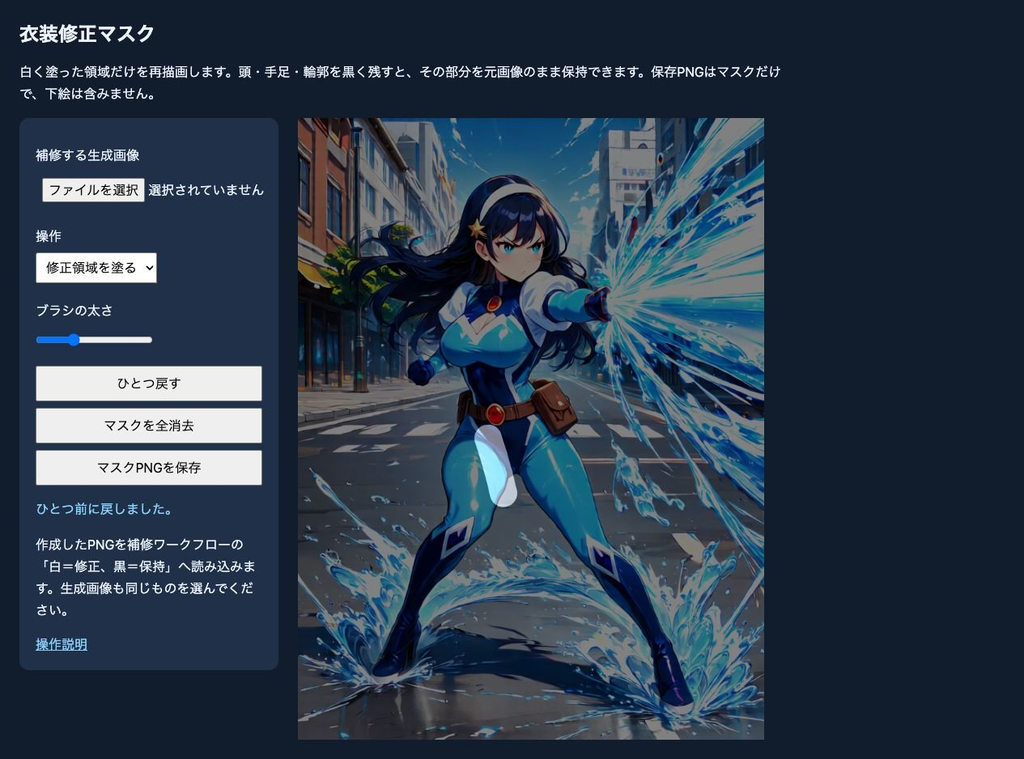
LoRAでキャラの特徴を覚えさせ、ControlNetで姿勢や構図を誘導するという考え方。ただし、これを組み合わせれば好きなポーズに完全固定できる、というところまではまだ到達していない。キャラクター、衣装、ポーズ、背景。全部まとめて一発で正解を出そうとすると、急に難易度が上がる。
まず単純な構図でキャラと衣装を確認し、それから動きを付ける方が、どこに問題があるのか分かりやすかった。
学習する場所をGoogle Colabへ
そんな感じで試行錯誤していたんだけど、途中で学習する場所をGoogle Colabへ移すことにした。
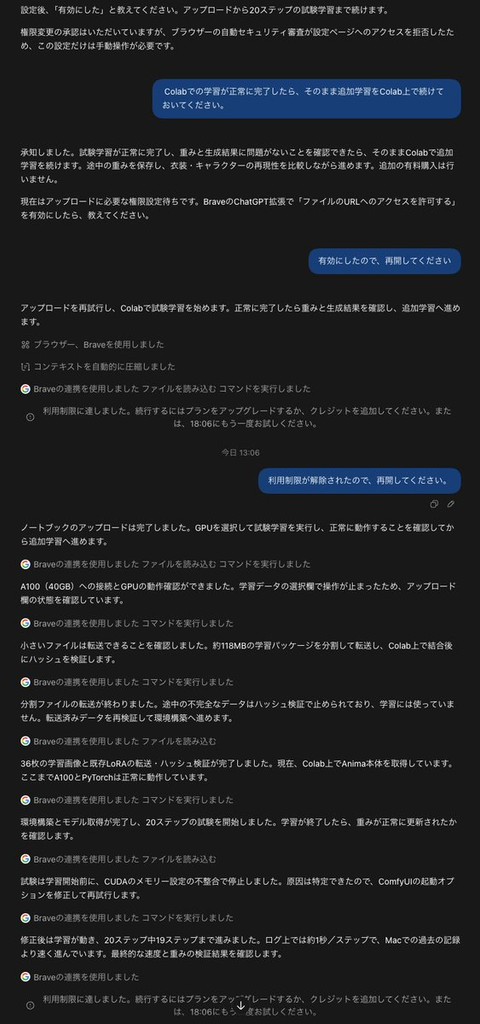
手元のPCだけで頑張るより、オンライン側のGPUを使うことでより高速に、かつ手元のPCに負担を掛けずにないかと思ったのがきっかけ。何しろ学習中はMac miniのGPU使用率は基本的に100%に張りつくような状態になる。普段ほぼ無音のMacminiが学習の時は普通にファンが回り出す。
Colabはブラウザーからコードを実行できる環境で、今回の作業ではクラウド側のGPUを使って学習させている。しかも自分はGoogle AI Proを既に契約してるので Colabの有料特典(VRAM40GBのA100GPU)が使える。A100GPUは新品なら200万ぐらいするらしいので、それを月三千円のサブスクに契約すれば使えるのは素晴らしい、というかなぜ今までこれを知らずに惰性でGoogleに貢いでたのかと過去の自分を問い詰めたい。
手元のPCは操作や結果の確認に使い、重い計算は向こうに任せる。自分のPCに高性能なGPUを積まなくても試せるのはありがたい。
ただし、ブラウザーから使えるからといって、全部が簡単になるわけではない。必要なライブラリを入れたり、学習用のファイルを渡したり、実行環境を準備する作業はある。それにGPUをずっと自由に使えるわけでもない。使えるリソースや残りの利用枠は確認が必要で、今回は追加購入をせず、AI Proプランで利用できる範囲で進めることにした。
Google Driveへの保存がかなり大事
Colabで特に気を付けたのが、作業したファイルの保存先。
Colabの実行環境にある一時ファイルは、セッションが終了すると失われることがある。学習した結果をそこに置きっぱなしにするのは怖い。長時間回して、終わったら全部なくなっていました、はさすがに笑えない。
そこでGoogle Driveに専用フォルダを作り、ベースモデル、学習画像、設定、LoRA、途中の学習状態を保存するようにした。これまたGoogle AI Proを契約していたおかげで5TB分のクラウドストレージを確保していた。メモリやストレージ高騰の時代に5TBは嬉しい。けど今回のようにAIを積極活用すること自体が高騰を招いていることを考えると素直に喜ぶべきか感がある。
とにかく、データをGoogle Driveに、学習をColabに移管することでクラウド上で完結させたい。
SDXLにも切り替えてみた
学習環境を整えるのと並行して、ベースモデルもAnimaからSDXL系のAnimagine XL 4.0へ切り替えてみた。
もちろんモデルを替えれば自動的に衣装が正確になるわけではない。今回は別のモデルでも試せるようにして、改めて結果を比較するための移行。
Anima向けのLoRAをSDXLにそのまま載せることはできないので、整理した24枚の画像から新しくLoRAを学習させている。そして案の定、最初からすんなりとは動かなかった。
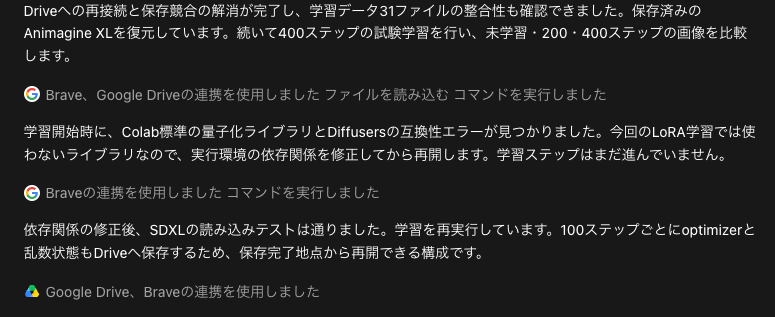
Colabに入っていた量子化用ライブラリと、今回使うDiffusersとの間で互換性エラーが発生。学習を始める前の読み込みで止まってしまった。今回はその量子化機能を使わないので、不要なライブラリを外して、SDXLが正常に読み込めることを確認してから再実行。こういう、絵とは全く関係なさそうなところでも普通につまずく。
修正後はA100を使って400ステップの試験学習が完了した。ログ上の学習時間は約9分。環境準備やモデルの転送まで全部含めた時間ではないけど、試して比較するための速度としてはかなりありがたい。
完成したLoRAはComfyUIで使える形式にも変換し、途中の学習状態と一緒にDriveへ保存できた。
A100に移したらどれぐらい速くなったのか
せっかくなので学習速度も比較してみた。Animaで学習していた時の記録では、手元のMacが1ステップ約11.3秒だったのに対して、ColabのA100では約0.8秒。学習が回っている部分だけで見ると、約14〜15倍速い。これは大変でかい。
| 比較項目 | ローカル (M4Pro Mac mini) | Colab (A100・40GB) |
|---|---|---|
| Anima学習の1ステップ | 約11.3秒※ | 約0.77〜0.81秒 |
| 100ステップ換算 | 約18分50秒 | 約77〜81秒 |
| 400ステップ換算 | 約1時間15分20秒 | 約5分8秒〜5分24秒 |
| 1,000ステップ換算 | 約3時間8分20秒 | 約12分50秒〜13分30秒 |
| 学習速度の比較 | 1倍 | 約14〜15倍 |
単純計算なら、Macで1時間15分ぐらいかかる400ステップ分の処理が、A100では5分ちょっとになる。もちろん実際にはモデルの読み込みやデータ転送などもあるので、作業全体がそのまま15倍速く終わるわけではない。それでも、学習して結果を見て、設定を変えてもう一度試す、という繰り返しの待ち時間はかなり減らせる。ちなみに後から試したSDXL版は、400ステップの学習が約9分で完了した。こちらはモデルも条件も違うので直接比較はできないけど、試行錯誤をするにはありがたい速度。
自分のキャラだからこそ気になる
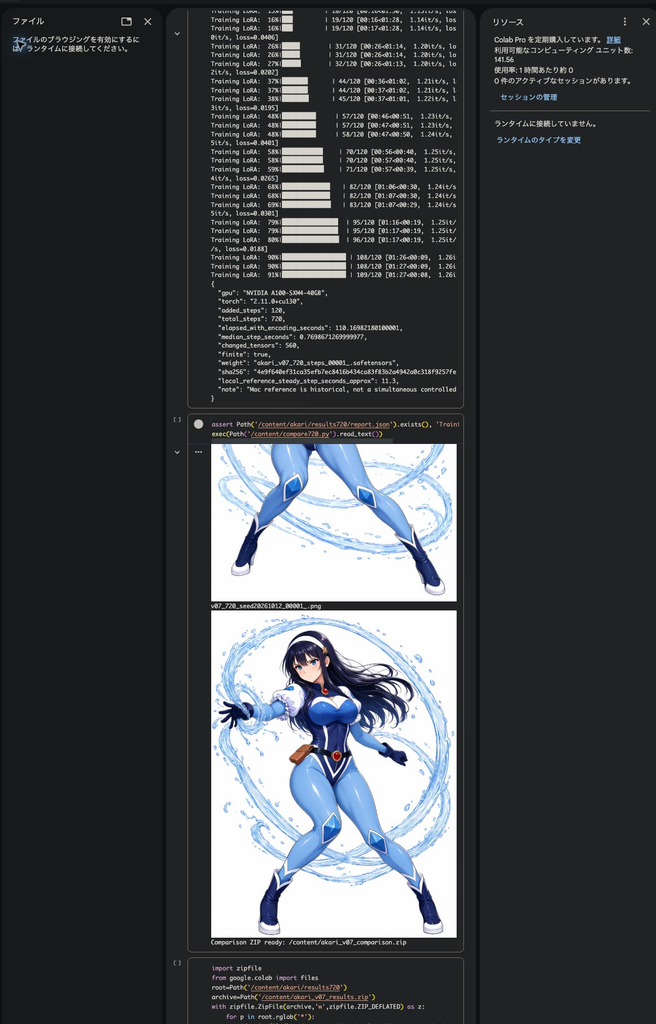
ここまでやってみて、LoRAを作ること自体より、自分の納得する精度まで持っていく方が大変なんだと感じた。知らないキャラなら綺麗で可愛ければそれで満足するかもしれない。でも自分のキャラだと、星の位置も服の線も気になる。顔は良いのにそこが違う、という惜しい画像が出るほど、もう少し直したくなる。
一方で、手元のPCだけで始めた作業を、ColabのGPUで回し、Driveに保存して次へ引き継げるところまで来たのは大きい。現時点で元の参考画像と同じ品質を安定して出せるようになった、とまでは言えない。SDXL版も、学習が完了したことと出来が良いことは別なので、これから画像を見て判断する必要がある。
次は衣装の再現性を確認しつつ、怪人との戦闘シーンをもっと安定して作れるようにしたい。自分で考えたヒーローが、設定画から抜け出して実際に戦っている。そこまで持っていけたら相当楽しいと思う。
とりあえず星飾りは、そろそろ定位置を覚えてほしい。
コメント